
Definition:Positional Encoding
位置エンコーディング(Positional Encoding)とは、系列データにおける各要素の順序情報をモデルに供給するための写像である。自己注意機構は入力を集合として処理するため順序不変であり、位置エンコーディングはこの欠如を補う目的で導入される。
語彙 $\mathcal{V}$ 上のトークン列 $(x_1, x_2, \ldots, x_n)$ に対し、各トークン $x_t$ が埋め込みベクトル $\mathbf{e}_t \in \mathbb{R}^d$ に写されるとき、位置エンコーディングは写像 $\mathrm{PE} : \mathbb{N} \to \mathbb{R}^d$ であり、モデルへの入力は $\tilde{\mathbf{e}}_t = \mathbf{e}_t + \mathrm{PE}(t)$ と定義される。
機械学習 > トランスフォーマーの基礎と数理 > エンコーダ・デコーダ構造
Vaswani et al.(2017)による固定サイン・コサイン型では、$\mathrm{PE}(t) \in \mathbb{R}^d$ の各成分を次のように定める。偶数インデックス $2i$ に対しては\[ \mathrm{PE}(t)_{2i} = \sin(t \cdot \omega_i), \quad \omega_i = 10000^{-2i/d} \]奇数インデックス $2i+1$ に対しては\[ \mathrm{PE}(t)_{2i+1} = \cos(t \cdot \omega_i) \]ここで $i = 0, 1, \ldots, d/2 - 1$ であり、各次元の角周波数 $\omega_i$ は次元インデックスに対して幾何級数的に減少する。この構成により、任意の固定オフセット $k$ に対して $\mathrm{PE}(t+k)$ が $\mathrm{PE}(t)$ の線形変換として表現可能であることが示される。すなわち $2 \times 2$ の回転行列 $M_k^{(i)}$ が存在して\[ \begin{pmatrix} \mathrm{PE}(t+k)_{2i} \\ \mathrm{PE}(t+k)_{2i+1} \end{pmatrix} = M_k^{(i)} \begin{pmatrix} \mathrm{PE}(t)_{2i} \\ \mathrm{PE}(t)_{2i+1} \end{pmatrix} \]が成立する。学習型絶対位置エンコーディングでは、最大系列長 $n_{\max}$ に対してパラメータ行列 $\mathbf{P} \in \mathbb{R}^{n_{\max} \times d}$ を定義し、$\mathrm{PE}(t) = \mathbf{P}[t]$ とする。この場合 $\mathrm{PE}$ は訓練データから最適化される。相対位置エンコーディングは、絶対位置ではなくトークン間の距離 $s - t$ に基づいて注意スコアを変調する。Shaw et al. (2018) の定式化では、スケール済み内積注意のスコアを\[ a_{t,s} = \frac{\mathbf{q}_t^\top \mathbf{k}_s + \mathbf{q}_t^\top \mathbf{r}_{s-t}}{\sqrt{d_k}} \]と定める。ここで $\mathbf{q}_t = \mathbf{W}_Q \tilde{\mathbf{e}}_t \in \mathbb{R}^{d_k}$、$\mathbf{k}_s = \mathbf{W}_K \tilde{\mathbf{e}}_s \in \mathbb{R}^{d_k}$ であり、$\mathbf{r}_{s-t} \in \mathbb{R}^{d_k}$ は相対距離 $s - t$ に対応する学習済みベクトルである。RoPE(Rotary Position Embedding、Su et al. 2021)は、クエリおよびキーに回転変換を施すことで、内積が相対位置のみの関数となる性質を実現する。次元 $d$ を偶数とし、各ブロック $i \in \{0, \ldots, d/2 - 1\}$ に対して角度 $\theta_i = 10000^{-2i/d}$ を定める。位置 $t$ における回転行列 $\mathbf{R}_t \in \mathbb{R}^{d \times d}$ はブロック対角行列であり、第 $i$ ブロックが\[ \mathbf{R}_t^{(i)} = \begin{pmatrix} \cos(t\theta_i) & -\sin(t\theta_i) \\ \sin(t\theta_i) & \cos(t\theta_i) \end{pmatrix} \]で与えられる。変換後のクエリおよびキーはそれぞれ $\hat{\mathbf{q}}_t = \mathbf{R}_t \mathbf{q}_t$、$\hat{\mathbf{k}}_s = \mathbf{R}_s \mathbf{k}_s$ であり、注意スコアは\[ a_{t,s} = \frac{\hat{\mathbf{q}}_t^\top \hat{\mathbf{k}}_s}{\sqrt{d_k}} = \frac{\mathbf{q}_t^\top \mathbf{R}_t^\top \mathbf{R}_s \mathbf{k}_s}{\sqrt{d_k}} \]となる。直交行列の性質 $\mathbf{R}_t^\top \mathbf{R}_s = \mathbf{R}_{s-t}$ により、このスコアは位置の差 $s - t$ のみに依存し、絶対位置に依存しない。ALiBi(Attention with Linear Biases、Press et al. 2022)は、位置ベクトルを明示的に付加するのではなく、注意スコアに線形ペナルティを加算する。ヘッド $h$ に対してスカラー傾き $m_h > 0$ を割り当て、スコアを\[ a_{t,s}^{(h)} = \frac{\mathbf{q}_t^\top \mathbf{k}_s}{\sqrt{d_k}} - m_h |t - s| \]と定義する。これにより距離が大きいトークン対の注意重みが抑制され、訓練時より長い系列への外挿性が向上する。
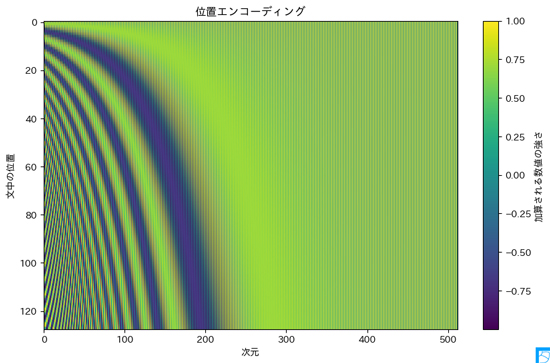
図は縦軸に文中の位置(0から127までのトークン順番)、横軸に埋め込み次元(0から511までの512次元)をとるヒートマップであり、各セルの色がその位置・次元に加算される数値の大きさをviridisカラーマップで表している。viridisでは紫が負値または小さい値、黄緑から黄が正値または大きい値に対応する。
横軸の左側(低次元)では、$\omega_i = 10000^{-2i/d}$ が大きいため角周波数が高く、色の縞が縦方向に細かく並ぶ。これは低次元のサイン・コサイン波が短い周期で振動していることを意味し、隣接するトークン同士を細かく区別する役割を担う。横軸の右側(高次元)では $\omega_i$ が小さくなり周期が長くなるため、色の変化がなだらかになる。これは文全体にわたる大局的な位置関係を表現する。
縦軸方向に各行を見ると、同じ次元でも行ごとに色が異なる。これがすなわち各トークン位置に固有のパターンであり、コード中のタイトルにある「住所を表す固有の模様」に相当する。異なる2行(2つのトークン位置)は512次元のベクトルとして互いに異なるパターンを持ち、モデルはこのパターンの差異から位置の違いを読み取る。
偶数次元には $\sin(t \cdot \omega_i)$、奇数次元には $\cos(t \cdot \omega_i)$ が格納されるため、隣り合う2次元はサインとコサインのペアを形成し、位相が $\pi/2$ ずれた波となる。これにより2次元ごとに単位円上の回転として解釈でき、任意の固定オフセット $k$ に対して
\[ \begin{pmatrix} \mathrm{PE}(t+k)_{2i} \\ \mathrm{PE}(t+k)_{2i+1} \end{pmatrix} = M_k^{(i)} \begin{pmatrix} \mathrm{PE}(t)_{2i} \\ \mathrm{PE}(t)_{2i+1} \end{pmatrix} \]
が成立するという線形変換可能性の根拠となる。ここで $M_k^{(i)}$ は角度 $k \cdot \omega_i$ の $2 \times 2$ 回転行列である。
カラーバーの値域はおよそ $-1$ から $1$ であり、これはサイン・コサイン関数の値域そのものである。したがって位置エンコーディングが埋め込みベクトルに加算されるとき、各次元への寄与は常にこの範囲に収まる。
Mathematics is the language with which God has written the universe.