
Definition:test statistic
検定統計量とは、標本から計算した一つの数値で仮説の採否を決めるための指標である。
具体的には、標本 $\boldsymbol{x} = (x_1, \ldots, x_n)$ から未知母数を含まずに計算できる可測関数\[ T : \mathcal{X} \rightarrow \mathbb{R} \]として定義され、その値 $T(\boldsymbol{x})$ をあらかじめ定めた棄却域 $R \subseteq \mathbb{R}$ と照合することで判定を行う。
棄却域 $R$ は、有意水準 $\alpha \in (0,1)$ に対して第一種の誤りの確率が $\alpha$ を超えないよう、すなわち、\[ \sup_{\theta \in \Theta_0} P_\theta\bigl(T(\boldsymbol{X}) \in R\bigr) \leq \alpha \]を満たすよう構成される。ここで $\Theta_0$ は $H_0$ のパラメータ空間である。
正規母集団の平均値に関する両側検定($z$検定)を例として、検定統計量の定義における主要概念を視覚化する。
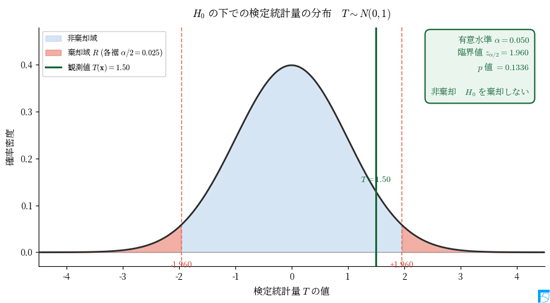
曲線は帰無仮説 $H_0 : \mu = \mu_0$ が真であるときの検定統計量\[T = \frac{\bar{X} - \mu_0}{\sigma / \sqrt{n}}\]の標本分布であり、$T \sim N(0, 1)$ に従う。検定の論理は、「もし $H_0$ が真ならば、$T$ はこの分布に従うはずである」という仮定に基づいており、観測された $T(\boldsymbol{x})$ の値がこの分布上のどこに位置するかによって判定を行う。青色の領域は非棄却域であり、$H_0$ と矛盾しないとみなされる $T$ の値の範囲を示す。赤色の両裾は棄却域 $R$ であり、有意水準 $\alpha$ を用いて\[R = \{ t \in \mathbb{R} \mid |t| \geq z_{\alpha/2} \}\]と定められる。本図では $\alpha = 0.05$、臨界値 $z_{\alpha/2} = 1.960$ であり、各裾の面積がそれぞれ $\alpha/2 = 0.025$ となるよう設定されている。この面積が、$H_0$ が真であるにもかかわらず誤って棄却してしまう確率、すなわち第一種の誤りの確率に対応する。緑色の縦線は観測された検定統計量の値 $T(\boldsymbol{x}) = 1.50$ を示す。この値は棄却域に属さない($1.50 < 1.960$)ため、$H_0$ は非棄却となる。対応する $p$ 値は $0.1336$ であり、これは $H_0$ の下で $|T| \geq 1.50$ となる確率を表す。$p$ 値が $\alpha = 0.05$ を上回ることは、棄却域に属さないことと同値である。
検定統計量の概念は近代統計学の成立とともに発展した。19世紀末までの統計学は主として記述統計や誤差論を中心としていたが、観測データから母集団について推論する方法論は十分に整備されていなかった。こうした状況の中で、イギリスの統計学者カール・ピアソン(Karl Pearson)は1900年にカイ二乗検定を発表し、カイ二乗統計量を導入することで観測度数と理論度数との差異を定量化する方法を提案した。
カール・ピアソンが導入したカイ二乗統計量\[\chi^2=\sum_{i=1}^{k}\frac{(O_i-E_i)^2}{E_i}\]は、今日の意味での検定統計量の代表例であり、仮説検定を体系的に実施するための基礎を築いた。ここで、$k$ は分類の総数(カテゴリ数)、$O_i$ は第 $i$ カテゴリにおける観測度数(標本から実際に観測されたデータの個数)、$E_i$ は第 $i$ カテゴリにおける期待度数(帰無仮説 $H_0$ の下で理論的に期待される度数)である。
続いて、1908年にはゴセット(William Sealy Gosset)が Student の筆名で小標本に対する推測論を発表した。彼が導入した $t$ 統計量は、母分散が未知である場合に標本平均の分布を正確に扱うことを可能にし、農業実験や工業統計など実験科学に大きな影響を与えた。なお、元文では「検定理論を発表」とあるが、ゴセットの1908年の論文("The Probable Error of a Mean")の主眼は $t$ 分布の導出と小標本における推測であり、検定の枠組みを明示的に整備したのはその後のフィッシャーらである。
1920年代になるとフィッシャー(Ronald Aylmer Fisher)が統計的推測の理論を大きく発展させた。フィッシャーは尤度関数の概念を整備し、十分統計量や最尤推定法の理論を確立した。また、検定統計量を用いて観測結果が帰無仮説とどの程度整合的であるかを $p$ 値によって評価する枠組みを提唱し、有意性検定(significance test)の基礎を築いた。
1930年代にはネイマン(Jerzy Neyman)とエゴン・ピアソン(Egon Pearson、カール・ピアソンの子)によって仮説検定の理論が数学的に体系化された。両者は第一種過誤(帰無仮説が真であるにもかかわらず棄却する誤り)と第二種過誤(対立仮説が真であるにもかかわらず棄却しない誤り)の概念を明確に定義し、与えられた有意水準 $\alpha$ の下で検出力(power)を最大化する検定を構成する理論を構築した。
特にネイマン=ピアソンの基本補題(Neyman–Pearson lemma)は、単純帰無仮説と単純対立仮説の間の検定において、尤度比統計量\[\Lambda(\boldsymbol{x}) = \frac{L(\theta_1 \mid \boldsymbol{x})}{L(\theta_0 \mid \boldsymbol{x})}\]に基づく棄却域が一様最強力検定(uniformly most powerful test, UMP test)を与えることを示した。この結果により、検定統計量は経験的・直感的な指標ではなく、数学的最適性を持つ推論装置として厳密に位置付けられるようになった。
Mathematics is the language with which God has written the universe.