
Definition:Skip Connection / Residual Connection
残差接続とは、ニューラルネットワークの層(レイヤー)において、層の入力をその層の処理(関数計算)を飛び越えて(スキップして)直接出力に足し合わせる構造のこと。
残差接続とは、ニューラルネットワークの層(レイヤー)において、層の入力をその層の処理(関数計算)を飛び越えて(スキップして)直接出力に足し合わせる構造のことである。層の変換を $F$、入力を $x$ とすると、その層の出力 $y$ は次式で表される。\[y = F(x) + x\]
すなわち、入力 $x$ をそのまま素通りさせる経路(ショートカット、あるいはアイデンティティ・マッピング)と、$F$ による変換を経た経路の両方を持ち、両者の和を出力とする構造である。
深層学習において、ネットワークの層を深くすればするほど表現力が増し、精度が向上すると素朴には期待される。しかし2010年代前半、CNNの層数を増やしていく実験の中で、ある層数を超えると訓練誤差そのものが悪化していく現象が観測されるようになった。これは過学習(訓練データにだけ適合し汎化性能が落ちる現象)とは異なり、訓練データに対する誤差自体が深いネットワークほど大きくなるという、直感に反する現象であった。この現象は劣化問題(degradation problem)と呼ばれる。
劣化問題の一因として、逆伝播の過程で勾配が層を遡るたびに繰り返し掛け合わされることにより、勾配が極端に小さくなる勾配消失(vanishing gradient)、あるいは逆に極端に大きくなる勾配爆発(gradient explosion)が生じ、深い層のパラメータが適切に更新されなくなることが挙げられる。バッチ正規化(Batch Normalization)などの手法により、ある程度この問題は緩和されていたが、数十層を大きく超える規模のネットワークを安定して学習させるには、なお不十分であった。
2015年、Microsoft Researchのカイミン・ホー(Kaiming He、何 愷明)らのグループが、この劣化問題に対する解決策として残差接続を提案し、これを組み込んだアーキテクチャをResNet(Residual Network)と名付けた。
ResNetの着想は次のようなものである。ある層のブロックに理想的な変換 $H(x)$ を直接学習させるのではなく、その変換から入力 $x$ を差し引いた残差(residual)\[F(x) = H(x) - x\]
を学習させ、最終的な出力は\[H(x) = F(x) + x\]
として、$F(x)$ と $x$ の和を出力とするようにブロックを設計する。この構造により、仮にそのブロックが「何も変換しないこと(恒等写像)」を学習すべき状況であっても、$F(x)$ をゼロに近づけるだけでよく、これは深いネットワークにとって恒等写像そのものを直接学習するよりも容易であるとカイミン・ホーらは主張した。
この設計により、ResNetは152層という、当時としては極めて深いネットワークの学習に成功し、2015年のImageNet画像認識コンペティション(ILSVRC)で優勝した。それ以降、数十層から百層を超える深いネットワークを安定して学習させるための標準的な手法として、残差接続は畳み込みニューラルネットワークの分野に広く普及した。
残差接続が学習を安定させる理由については複数の観点から説明される。
第一に、勾配伝播の観点である。出力 $y = F(x) + x$ を $x$ について微分すると、\[\frac{\partial y}{\partial x} = \frac{\partial F(x)}{\partial x} + 1\]
となる。この式の右辺に定数項の $1$ が常に存在するため、$\partial F(x) / \partial x$ がどれほど小さくなっても、勾配がゼロに潰れることを防ぐ経路が確保される。逆伝播時にこの恒等成分を通じて勾配が直接的に浅い層まで伝わるため、層を深く積み重ねても勾配消失が起こりにくくなる。
第二に、最適化のしやすさという観点である。恒等写像に近い変換を学習する必要がある場合、残差接続がない構造では変換全体をゼロから恒等写像に近づけるよう学習しなければならないのに対し、残差接続がある構造では $F(x)$ をゼロに近づけるだけでよく、最適化の難度が下がるとされる。
2017年に発表されたTransformerにおいても、残差接続は各サブレイヤーの構成要素として採用されている。Transformerの各層は、自己アテンション(Self-Attention)サブレイヤーと、位置ごとのフィードフォワードネットワーク(Position-wise Feed-Forward Network)サブレイヤーという、2種類のサブレイヤーから構成される。それぞれのサブレイヤーの出力には、レイヤー正規化(Layer Normalization)と組み合わせた形で残差接続が適用される。\[\text{output} = \text{LayerNorm}(x + \text{SubLayer}(x))\]
ここで $\text{SubLayer}(x)$ は、自己アテンションまたはフィードフォワードネットワークによる変換を表す。Transformerは1層につき、自己アテンションの後とフィードフォワードの後の2箇所でこの構造を用いており、これにより層を多数積み重ねても勾配が浅い層まで安定して伝わり、大規模なモデルの学習が可能になっている。
【Transformerの基本構造】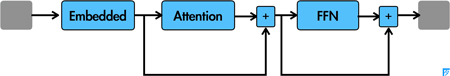
ResNetが提示した「入力をバイパスして加算する」という着想が、畳み込みネットワークという枠を超えて、注意機構をベースとするアーキテクチャの標準的な構成要素としても定着した形である。
Mathematics is the language with which God has written the universe.