
Definition:Self-Attention
自己アテンション機構とは、アテンション機構においてQuery、Key、Valueのすべてが同一の入力系列(同じ文章内のトークン列)から生成される仕組みのことである。
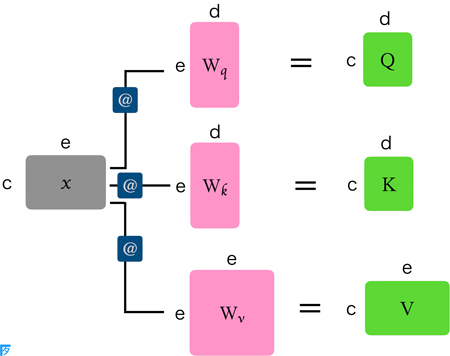
具体的には、入力されたトークン系列の各表現に対して、それぞれ異なる3つの学習済み重み行列を掛けてQuery、Key、Valueを算出する。あるトークンのQueryと、同じ系列内にあるすべてのトークンのKeyとの類似度(内積)を計算し、それをKeyベクトルの次元数の平方根でスケーリングした上で softmax により正規化し、アテンション重みを求める。この重みに基づいて同じ系列内の全トークンのValueベクトルを線形結合することで、自身の系列内におけるトークン間の依存関係や文脈情報を直接捉え、各トークンの特徴量ベクトルを更新する機構である。
自己アテンション(Self-Attention)機構とは、アテンション機構の一種であり、Query、Key、Valueのすべてが同一の入力系列(同じ文章内のトークン列)から生成される仕組みのことである。Transformerモデルの中核をなす機構であり、系列内の任意の2トークン間の関係を、距離に関係なく直接的に計算できる点に最大の特徴がある。
従来のRNNやLSTMでは、遠く離れたトークン同士の関係を捉えるためには、その間にある全てのトークンを順番に経由して情報を伝播させる必要があり、系列が長くなるほど情報が劣化しやすいという問題があった。自己アテンションはこの問題を解消し、任意の2トークン間の関連度を1ステップで直接計算する。
入力系列を $X = (x_1, x_2, \ldots, x_n)$ とする。ここで各 $x_i$ は、あるトークンの埋め込みベクトル(またはその上位層における中間表現)である。
各トークン表現 $x_i$ に対して、3つの異なる学習済み重み行列 $W^Q$、$W^K$、$W^V$ をそれぞれ掛け合わせることで、Query、Key、Valueの各ベクトルを算出する。\[q_i = x_i W^Q, \quad k_i = x_i W^K, \quad v_i = x_i W^V\]
系列全体をまとめて行列表記すると、次のようになる。\[Q = X W^Q, \quad K = X W^K, \quad V = X W^V\]
$W^Q$、$W^K$、$W^V$ はいずれも学習によって獲得されるパラメータであり、同一の入力 $X$ から出発しながらも、Query・Key・Valueという異なる役割を持つ空間へ線形変換する点が重要である。
あるトークン $i$ のQuery $q_i$ と、同じ系列内にあるすべてのトークンのKey $k_1, k_2, \ldots, k_n$ との類似度を、内積によって計算する。\[\text{score}(i, j) = q_i \cdot k_j\]
行列表記では、以下のように系列全体の類似度をまとめて計算できる。\[S = Q K^{\top}\]
ここで得られる行列 $S$ の各要素 $S_{ij}$ が、トークン $i$ のQueryとトークン $j$ のKeyとの類似度に対応する。
内積によって得られた類似度は、Key・Queryベクトルの次元数 $d_k$ が大きくなるほど値の分散が大きくなりやすい。この値をそのままsoftmaxに入力すると、勾配が極端に小さくなる(softmaxの飽和領域に入り込む)という問題が生じる。これを避けるため、内積の結果を $\sqrt{d_k}$ で割るスケーリング処理を行う。\[\text{scaled\_score}(i, j) = \frac{q_i \cdot k_j}{\sqrt{d_k}}\]
行列表記では以下の通りである。\[S' = \frac{QK^{\top}}{\sqrt{d_k}}\]
この操作は元のTransformer論文における「Scaled Dot-Product Attention」の名称の由来となっている部分であり、自己アテンションの数値的安定性を担保するために不可欠な処理である。
スケーリング済みの類似度に対して、行方向(すなわち、あるトークン $i$ から見た系列内の全トークン $j$ に対する類似度の集合)にsoftmax関数を適用し、正規化する。これによりアテンション重み $\alpha_{ij}$ が得られる。\[\alpha_{ij} = \frac{\exp\left(\dfrac{q_i \cdot k_j}{\sqrt{d_k}}\right)}{\displaystyle\sum_{m=1}^{n} \exp\left(\dfrac{q_i \cdot k_m}{\sqrt{d_k}}\right)}\]
この正規化により、各トークン $i$ について、系列内の全トークン $j$ に対する重み $\alpha_{ij}$ の総和が1になる。すなわち、トークン $i$ が系列内のどのトークンに対してどれだけ「注意」を払うべきかを表す確率分布とみなすことができる。
最後に、算出されたアテンション重み $\alpha_{ij}$ を用いて、同じ系列内の全トークンのValueベクトル $v_j$ を加重線形結合し、トークン $i$ の新しい特徴量ベクトル $z_i$ を得る。\[z_i = \sum_{j=1}^{n} \alpha_{ij} v_j\]
系列全体をまとめた行列表記では、以下の一つの式に集約される。\[Z = \text{softmax}\left(\frac{QK^{\top}}{\sqrt{d_k}}\right) V\]
この $Z$ が自己アテンション層の出力であり、各行 $z_i$ が、系列内の他トークンとの関連度に応じて文脈情報を取り込んだ、トークン $i$ の更新済み表現に相当する。
自己アテンションの本質は、Query・Key・Valueという3つの異なる役割を、単一の入力系列から生成した射影ベクトルとして扱う点にある。これにより、以下が実現される。
なお、実際のTransformerでは、この自己アテンションを複数組(ヘッド)並列に用いるマルチヘッドアテンション(Multi-Head Attention)が採用されており、各ヘッドが異なる部分空間・異なる観点からトークン間の関係を捉える構成になっている。
Mathematics is the language with which God has written the universe.