
位置エンコーディング(Positional Encoding)とは、Transformerモデルにおいて単語(トークン)の並び順(位置情報)をモデルに伝えるための技術。
Transformerの核となる自己注意機構(Self-Attention)は、データを並列で一時に処理するため、単語の順番(例:「犬が人を噛んだ」と「人が犬を噛んだ」の違い)を区別できない。そのため、単語の埋め込みベクトル(Embedding)に位置の情報を足し合わせる必要がある。
この位置情報をどのように表現するかによって、大きく固定式と学習式に分かれ、さらにその発展形として相対位置エンコーディングがある。
固定式は、元論文『Attention Is All You Need』で提案された、数式(正弦波・余弦波)を用いて位置を決める方法。
偶数次元にサイン、奇数次元にコサイン関数を使い、独自の周期波形を位置情報として埋め込むことを特徴とする。パラメータを学習しない(固定されている)ため、事前学習時よりも長い系列(未知の長さ)のテキストが来ても計算によって位置情報を生成できる。
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn


class PositionalEncoding(nn.Module):

    def __init__(self, d_model, max_len=5000):
        """引数:

        d_model: 単語ベクトルの次元数 max_len: 許容する最大系列長(トークン数)
        """
        super(PositionalEncoding, self).__init__()

        # 位置エンコーディング行列の初期化 (max_len, d_model)
        pe = torch.zeros(max_len, d_model)

        # 0からmax_len-1までの位置インデックス (max_len, 1)
        position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)

        # 周波数(分母の部分)の計算。偶数インデックス(2i)に対応
        # 10000^(2i/d_model) = exp(2i * -(log(10000.0) / d_model))
        div_term = torch.exp(
            torch.arange(0, d_model, 2).float() * (-np.log(10000.0) / d_model)
        )

        # 偶数次元にはsin、奇数次元にはcosを適用
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)

        # バッチサイズ用の次元を追加して (1, max_len, d_model) にする
        pe = pe.unsqueeze(0)

        # 勾配更新(学習)の対象外とするために register_buffer を使用
        self.register_buffer("pe", pe)

    def forward(self, x):
        """引数 x:

        入力埋め込みベクトル (バッチサイズ, 系列長, 次元数)
        """
        # 入力テキストの長さ分だけ位置エンコーディングを足し合わせる
        x = x + self.pe[:, : x.size(1)]
        return x


# --- 1. 動作確認 ---
# パラメータ設定
d_model = 128  # 埋め込み次元数
max_len = 50  # 視覚化する系列長(トークン数)

# ダミーの入力データを作成 (バッチサイズ=1, 系列長=50, 次元数=128)
dummy_input = torch.zeros(1, max_len, d_model)

# インスタンス化と実行
pos_encoder = PositionalEncoding(d_model=d_model, max_len=max_len)
encoded_output = pos_encoder(dummy_input)

print(f"入力の形状: {dummy_input.shape}")
print(f"位置エンコーディング後の形状: {encoded_output.shape}\n")

# --- 2. ヒートマップによる視覚化 ---
# 登録した位置エンコーディング行列を取り出して numpy に変換
pe_matrix = pos_encoder.pe.squeeze(0).cpu().numpy()

plt.figure(figsize=(12, 6))
# 縦軸に位置(トークンの順番)、横軸にベクトルの次元をプロット
plt.pcolormesh(pe_matrix, cmap="RdBu")
plt.xlabel("Embedding Dimension (d_model)")
plt.ylabel("Token Position")
plt.colorbar(label="Value")
plt.title("Sinusoidal Positional Encoding Matrix")
plt.show()
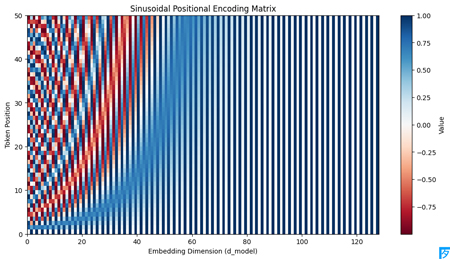
このコードを実行すると、以下のような赤と青のグラデーション模様(ヒートマップ)が描画される。縦軸は、文章の何番目の単語かを表している(系列長 $max\_len = 50$)。上が1番目の単語、下が50番目の単語。横軸は、位置を表すベクトルの次元数($d_{model} = 128$)を表している。
色は計算された位置エンコーディングの値そのもの。青がプラス(最大 $1$)、赤がマイナス(最小 $-1$)、白がゼロ付近を表わしている。
グラフの左端(次元0〜20あたり)を見ると、赤と青のシマシマが縦に細かく交互に並んでいる。これは波の周期がとても短い(高周波数)ことを示している。単語の位置が「1、2、3…」と1つズレるだけで色が変わるため、すぐ隣の単語との細かい違いを識別する役割を持っている。
グラフの右側(次元100〜128あたり)に目を移すと、シマシマがなくなり、上から下にかけて青から白、赤へとゆっくり色が変化している。これは波の周期が非常に長い(低周波数)ためです。ここでは、単語が文章の前半にあるのか、後半にあるのかというマクロで大まかな位置を識別する役割を持っています。
縦軸(位置)の「5番目」の横一行の色パターンと、「35番目」の横一行の色パターンを見比べてみる。全く違う色の組み合わせ(波の形)になっている。この「128次元の色パターンの違い」こそが、Transformerにとっての「私は○番目の文字です」というユニークなIDになっている。
なお、
div_term = torch.exp(
    torch.arange(0, d_model, 2).float() * (-np.log(10000.0) / d_model)
)
というコードを、数式に直すと、各次元 $2i$(0, 2, 4…)における波の細かさ(周波数)を決める値 div_term は、以下のようになる。\[div\_term=\frac{1}{10000^{\frac{2i}{d_{model}}}}\]
そして、実際にサイン関数に入力される値は position * div_term 。つまり、以下のような計算をしている。 \[\sin \left(pos\times \frac{1}{10000^{\frac{2i}{d_{model}}}}\right)\]
今回の設定(次元数 $d_{model} = 128$)で、グラフのいちばん左(次元0)と、いちばん右(次元128)で分母がどうなるか、実際に計算してみる。
いちばん左側(次元 $2i = 0$ のとき)においては、分母は $10000^{\frac{0}{128}} = 10000^0 = 1$ になる。つまり、式は $\sin(pos \times 1)$ 。トークンの位置($pos$)が 1, 2, 3... と増えるごとに、中身も 1, 2, 3... とそのまま増えるので、波は普通に細かく変化する。これが左側の細かい縞模様の正体。
いちばん右側(次元 $2i = 128$ のとき) において、分母は $10000^{\frac{128}{128}} = 10000^1 = 10000$ になる。つまり、式は $\sin(pos \times \frac{1}{10000}) = \sin(\frac{pos}{10000})$ 。トークンの位置($pos$)が 1, 2, 3... と増えても、1万で割られているため、中身は 0.0001, 0.0002, 0.0003... と微量しか増えない。
サイン関数($\sin x$)が山から谷へ1周(1周期)するのには、中身が約6.28($2\pi$)増える必要がある。左端(次元0)においては、$pos$ が 6 増えるだけで1周する。一方、右端(次元128)においては、$pos$ が 6万増えないと1周しない。
今回のグラフの縦軸(トークン数)は 50 までしかない。右端の次元にとっては、6万まで行ってようやく1周するのに、たった50までしか進まない状態。そのため、波の最初のスタート地点(0.0〜0.005あたり)の、ほんのわずかな色の変化(なだらかなグラデーション)しかグラフ上では表現されない。
Mathematics is the language with which God has written the universe.