
Definition:Attention
LLMにおけるアテンション機構/注意機構とは、各トークンの表現に3つの異なる学習済み重み行列をそれぞれ掛けて得られる、Query(照合する対象の特徴を表すベクトル。「どのトークンに注目するか」を決めるためのベクトル。)、Key(各照合される対象の特徴を表すベクトル。「どのトークンから注目されるか」を決めるためのベクトル。)、Value(照合された対象から取り出す情報を表すベクトル)の3種類のベクトルを用い、あるトークンのQueryと全トークンのKeyとの類似度(内積)を計算し、それをsoftmaxで正規化した重みに基づいて全トークンのValueベクトルを線形結合することで、各トークンに他のトークンから得られる情報を取り込み、文脈を内包した高次元の特徴量ベクトルへと変換・更新する機構である。
\[Q = X W_Q,\qquad K = X W_K,\qquad V = X W_V\]
$Q$ の $i$ 行目 $q_i$ は $i$ 番目のトークンのQueryベクトル、$K$ の $j$ 行目 $k_j$ は $j$ 番目のトークンのKeyベクトル、$V$ の $j$ 行目 $v_j$ は $j$ 番目のトークンのValueベクトルである。
これを直感的に理解するため、果物について記述された文を考える。例えば、ある文の中に「カリン」というトークンがあり、同じ文脈に「りんご」「みかん」「レモン」などのトークンが含まれているとする。このとき、「カリン」に対応するQueryと、「りんご」「みかん」「レモン」などに対応するKeyをそれぞれ照合する。ここでいう照合とは、QueryとKeyのベクトル同士の内積を計算し、どの組み合わせの関連性が強いかを数値として求めることである。したがって、QとKは「何を探す」「何を提供する」といった人間的な意味を直接持つものではなく、両者を照合することで、トークン間の関連性を計算するためのベクトルとして理解するのが適切である。
まず、あるトークン $i$ のQueryベクトル $q_i$ と、全トークンのKeyベクトル $k_j$ との類似度(内積)を計算する。
\[score(i,j) = q_i \cdot k_j\]
例えば「カリン」のQueryと「りんご」「みかん」「レモン」のKeyをそれぞれ照合すると、「カリン」と「りんご」の組み合わせ、「カリン」と「みかん」の組み合わせ、「カリン」と「レモン」の組み合わせについて、それぞれ異なるスコアが得られる。スコアが大きいほど、現在処理している「カリン」の表現にとって、そのKeyを持つトークンとの関連性が強いことを意味する。
このスコアをKeyの次元数 $d_k$ の平方根で割ってスケーリングする。
\[scaled\_score(i,j) = \frac{score(i,j)}{\sqrt{d_k}}\]
これは、内積の値が大きくなりすぎることによってsoftmaxの出力が極端に偏ることを抑えるためである。
次に、この $scaled_score$ に対して $j$ 方向にsoftmaxを適用することで、各トークンに対する重みを求める。重みの合計は1になる。
\[A(i,j) = softmax_j(scaled\_score(i,j))\]
例えば「カリン」を処理している場合、「りんご」「みかん」「レモン」などに対応する重みが得られる。仮に「りんご」に対する重みが大きく、「みかん」に対する重みが小さければ、「カリン」の新しい表現を作る際には「りんご」から取り込む情報の割合が大きく、「みかん」から取り込む情報の割合が小さくなる。
ここで重要なのがValueである。Keyは照合によって重みを決めるために使われるのに対し、Valueは、その重みに従って実際に取り込まれる情報である。「カリン」のQueryと「りんご」「みかん」「レモン」のKeyを照合して重みを求めた後、その重みを「りんご」「みかん」「レモン」のValueに適用する。
最後に、この重み $A(i,j)$ を用いて全トークンのValueベクトルを線形結合し、トークン $i$ の新しい出力ベクトルを得る。
\[output_i = A(i,1)v_1 + A(i,2)v_2 + \cdots + A(i,n)v_n\]
つまり「カリン」の出力ベクトルは、「カリン」自身を含む文中の各トークンのValueを、QueryとKeyの照合結果に応じた重みで混ぜ合わせたものになる。これによって、「カリン」の元の表現だけではなく、文脈中の他のトークンから得られた情報を含む新しい表現が生成される。
これを行列形式でまとめて書くと、次のScaled Dot-Product Attentionの式になる。
\[Attention(Q,K,V) = softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]
この一連の処理によって、各トークンの表現は、単独の静的な埋め込みベクトルから、文脈中の他のトークンとの関連性に応じて情報を取り込んだ動的な特徴量ベクトルへと更新される。例えば「カリン」という同じトークンであっても、「カリンは果物である」という文脈に置かれた場合と、「カリンの香りを利用した」という文脈に置かれた場合では、周囲のトークンとの関連性が異なるため、Attention後の「カリン」の表現も異なるものになる。このようにして、Attentionはトークンの表現に文脈を取り込む役割を果たす。
実際のTransformerでは、この処理を単一のQ・K・Vの組で行うのではなく、複数の異なる重み行列の組(ヘッド)を用いて並列に行うMulti-Head Attentionが採用されている。各ヘッドは異なる表現空間でトークン間の関連性を計算するため、あるヘッドでは構文的な関係、別のヘッドでは意味的な関係など、異なる特徴を捉えることができる。
\[head_i = Attention(QW^Q_i,KW^K_i,VW^V_i)\]
\[MultiHead(Q,K,V) = Concat(head_1,head_2,\ldots,head_h)W^O\]
例えば「カリン」というトークンについて、あるヘッドでは「果物」という意味的な関連を強く捉え、別のヘッドでは「食べる」のような動作との関係を強く捉える、といったように、複数のヘッドが異なる観点からトークン間の関係を計算できる。各ヘッドの出力を結合し、さらに出力重み行列を掛けることで、複数の観点から得られた情報を統合した表現を生成する。
また、GPTのような自己回帰型のデコーダでは、あるトークンが自分より未来の位置にあるトークンを参照できないよう、未来の位置に対応する $scaled_score$ を非常に小さい値(理論上は負の無限大)にしてからsoftmaxを適用する因果マスクが用いられる。例えば「カリンは」という入力から次のトークンを生成するとき、その次に現れるべきトークンをすでに参照できてしまうと生成処理として不適切である。そのため、現在位置より後ろのトークンにはAttentionの重みが付かないようにする。これにより、文を先頭から順に生成する処理と整合性を保っている。
計算量の観点では、この機構は系列長 $n$ に対してAttentionの重みを計算する部分で $O(n^2)$ の計算量とメモリを要する。これは、各トークンのQueryと全トークンのKeyとの組み合わせについて類似度を計算するためである。例えば100個のトークンなら10,000通り、1,000個のトークンなら1,000,000通りの組み合わせが生じる。この二次的な増加が、長い文脈を扱う際の大きなボトルネックとなる。この制約への対応として、FlashAttentionによるメモリ効率化、Sparse Attention、線形Attention、あるいはSSM(状態空間モデル、Mambaなど)といった代替・改良手法が提案されている。
さらに、Attention自体はトークンの順序を区別しないため、単語の並び順という情報を別途モデルに与える必要がある。これがPositional Encoding(正弦波型、学習型埋め込み、RoPEなど)である。位置情報を入力表現に加えたり、RoPEのようにQuery・Keyに位置に応じた回転変換を施したりすることで、Attentionによる処理にトークンの位置関係を反映させることができる。
クエリー、キー、バリューの行列のイメージを示す。
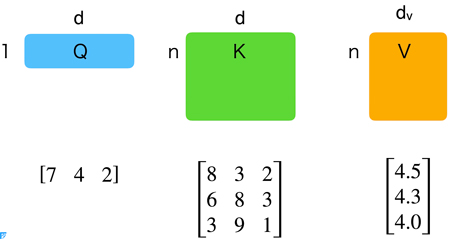
import numpy as np

# カリンの属性(Query)
# [甘さ, 酸味, 色]
Q = np.array([7, 4, 2])

# 既存果物の属性(Key)
# [甘さ, 酸味, 色]
K = np.array([
    [8, 3, 2],  # りんご
    [6, 8, 3],  # みかん
    [3, 9, 1],  # レモン
])

# 既存果物の評価(Value)
V = np.array([
    4.5,  # りんご
    4.2,  # みかん
    4.0   # レモン
])

# カリンQと各果物Kの類似度(内積)
scores = K @ Q

# Softmaxで重みに変換
weights = np.exp(scores) / np.exp(scores).sum()

# 評価を重み付きで合成
output = weights @ V

print("類似度:", scores)
print("重み:", weights)
print("カリンの予測評価:", output)
出力結果は、
類似度: [72 80 59]
重み: [3.35350130e-04 9.99664649e-01 7.58001761e-10]
カリンの予測評価: 4.2001006048874645
Mathematics is the language with which God has written the universe.