
位置エンコーディング(Positional Encoding)とは、Transformerモデルにおいて単語(トークン)の並び順(位置情報)をモデルに伝えるための技術。
Transformerの核となる自己注意機構(Self-Attention)は、データを並列で一時に処理するため、単語の順番(例:「犬が人を噛んだ」と「人が犬を噛んだ」の違い)を区別できない。そのため、単語の埋め込みベクトル(Embedding)に位置の情報を足し合わせる必要がある。
この位置情報をどのように表現するかによって、大きく固定式と学習式に分かれ、さらにその発展形として相対位置エンコーディングがある。
固定式は、元論文『Attention Is All You Need』で提案された方式であり、正弦波と余弦波による数式から各位置のベクトルを決定する方法である。例えば、2番目のトークンには位置2に対応するベクトル、3番目のトークンには位置3に対応するベクトルを与えるが、これらの位置ベクトル自体をニューラルネットワークの学習によって変更することはない。位置 $i$ のベクトルは、あらかじめ定められた正弦・余弦関数によって計算される。
学習式は、位置ごとのベクトルをニューラルネットワークのパラメータとして用意し、モデルの学習によってその値を更新する方法。
例えば、最大系列長が $N$、埋め込み次元が $d$ なら、位置エンコーディングは\[P= \begin{bmatrix} P_0\\ P_1\\ \vdots\\ P_{N-1} \end{bmatrix} \]
という $N\times d$ の学習可能な行列として保持される。トークン $x_i$ の埋め込みベクトルを $E(x_i)$、その位置を $i$ とすると、実際にTransformerへ入力するベクトルは\[X_i=E(x_i)+P_i\]
となる。ここで重要なのは、$E(x_i)$ と $P_i$ を足し合わせる計算そのものを学習するわけではないという点。足し算は通常の計算であり、学習されるのは位置 $i$ に対応するベクトル $P_i$ の値である。モデルが入力から損失 $L$ を計算すると、その誤差から\[\frac{\partial L}{\partial P_i}\]
という勾配が計算され、勾配降下法などによって、\[P_i \leftarrow P_i - \eta \frac{\partial L}{\partial P_i}\]
のように $P_i$ が更新される。したがって、固定式が「位置を数式によって決める」方式であるのに対し、学習式は「各位置のベクトルをパラメータとして持ち、学習によって値を決める」方式ということになる。つまり、学習式位置エンコーディングの本質は「位置 $i$ に対してランダムに値を置く」ことではなく、「その初期値を学習によって適切な位置ベクトルへ変化させる」というところにある。
語彙(vocab_size)は5種類、系列長(seq_len)も5、ベクトルの次元(d_model)は2次元の場合で学習式位置エンコーディングを行う。PyTorchが使用する乱数の種(seed)を42に固定。また、計算をGPUで行えるならGPUを使い、使えなければCPUを使う。実際に選ばれたデバイスを表示するようにしている。
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt


vocab_size = 5
seq_len = 5
d_model = 2

torch.manual_seed(42)

device = "cuda" if torch.cuda.is_available() else "cpu"

print("device:", device)
次に、トークンの埋め込みを行う。
#トークン埋め込み

token_embedding = nn.Embedding(
    vocab_size,
    d_model
).to(device)
nn.Embedding は、トークンIDごとに1つのベクトルを持つ表を作るもの。token_embedding = nn.Embedding(5, 2)とすると、トークンIDは 0~4 の5種類、各トークンに2個の数値からなるベクトルを割り当てる。内部では次のような表が作られる。\[E= \begin{bmatrix} e_0\\ e_1\\ e_2\\ e_3\\ e_4 \end{bmatrix} = \begin{bmatrix} 0.2 & -0.3\\ 0.5 & 0.1\\ -0.1 & 0.7\\ 0.4 & -0.2\\ -0.3 & 0.2 \end{bmatrix} \]
ここで、\[e_0=(0.2,-0.3)\]
はトークンID 0 に対応するベクトルであり、\[e_2=(-0.1,0.7)\]
はトークンID 2 に対応するベクトル。したがって、token_embedding(torch.tensor([2])) とすると、表からID 2 の行を取り出して、\[(-0.1,0.7) \]
を返す。
.to(device)で、nn.Embedding が持っているデータを、指定した計算装置に移す。
続いて、各位置に対応するベクトルを、最初はランダムな値で作り、それを学習によって更新されるパラメータとして登録する。nn.Parameter(...) は、ランダムな数値からなる行列を学習によって値を変更する対象としてPyTorchに登録するもの。
#学習可能な位置エンコーディング

position_embedding = nn.Parameter(
    torch.randn(seq_len, d_model, device=device)
)
Transformerの入力表現から、各トークンがどの語彙に対応するかを予測するための線形層を作る。nn.Linear(2, 5) は、内部に次の2種類の学習パラメータ(output.weight、output.bias)を持つ。線形層が行う計算は、\[Y=XW^T+b\]
入力の次元が2、出力の次元が5なので、\[W\in\mathbb{R}^{5\times2}\] \[b\in\mathbb{R}^{5}\]となる。
#出力層

output = nn.Linear(
    d_model,
    vocab_size
).to(device)
続いて、学習によって値を変更するパラメータをまとめる。変更するパラメータは、トークン埋め込みの値(token_embedding.weight)、位置エンコーディングの値(position_embedding)、線形層の重み(output.weight)、線形層のバイアス(output.bias)の4つ。
SGDは Stochastic Gradient Descent(確率的勾配降下法) の略で、学習でパラメータの値を少しずつ調整するための方法。loss.backward() によって、損失 loss を小さくするには各パラメータをどちらへ動かせばよいかを計算する。
その計算結果を使って、optimizer.step() がが次のパラメータを計算する。基本的な式で書くと、\[\theta_{\mathrm{new}} = \theta_{\mathrm{old}} - \eta \frac{\partial L}{\partial \theta}\]
ここで、
lossloss.backward() で求められる勾配lrつまり、SGDは損失が小さくなるように、トークン埋め込み・位置エンコーディング・出力層の重み・出力層のバイアスを更新するという役割を担っている。
#学習するパラメータ

parameters = [
    token_embedding.weight,
    position_embedding,
    output.weight,
    output.bias
]

optimizer = torch.optim.SGD(
    parameters,
    lr=0.1
)
入力は5個のトークン。
#データ

# 5個のトークン
x = torch.tensor(
    [[0, 1, 2, 3, 4]],
    device=device
)

# 正解
# 位置0 → 1
# 位置1 → 2
# 位置2 → 3
# 位置3 → 4
# 位置4 → 0
y = torch.tensor(
    [[1, 2, 3, 4, 0]],
    device=device
)
次に、現在の position_embedding の値をコピーして保存する。position_embedding は、この後の学習によって値が変更される。そのため、学習前の値を残しておかないと、学習後に学習によってどれだけ変化したのかを確認できない。そこで、position_before という別のテンソルに保存する。
detach() で、このコピーを勾配計算の対象から外す。clone() で、現在の値をコピー。
for i in range(seq_len): では、i を0から4まで変化させる。
その上で、それぞれの位置の位置エンコーディングを表示。
#学習前の位置エンコーディング

position_before = position_embedding.detach().clone()

print("\n【学習前の位置エンコーディング】")

for i in range(seq_len):
    print(
        f"位置 {i}: "
        f"{position_before[i].cpu().numpy()}"
    )
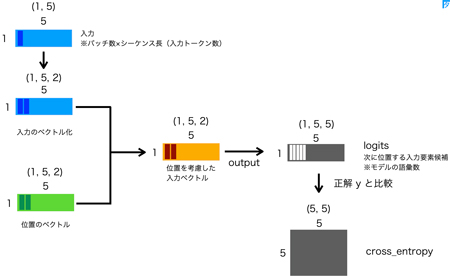
ここから、実際に学習を行う。1回の繰り返しで、
を処理する。これを500回繰り返す。
optimizer.zero_grad() は、前回の計算でパラメータに蓄積された勾配をゼロにする処理。これから新しい勾配を計算するための準備となる。
X = E + P でトークンのベクトルと位置のベクトルを加算。logits は、各位置について、5種類のトークンそれぞれに対応する5個の値。これをそのまま次の F.cross_entropy() に渡す。そして、logits と正解 y を比較して損失を計算。
ここで、各位置について、5個の候補から正解の1個を選ぶために、5つの位置の予測を cross_entropy でまとめて計算できる形にする必要がある。
reshape(-1, vocab_size) の -1 は、残りの要素数から自動的に計算することを指示するもの。今回の logits は、$(1, 5, 5)$ であるので、全部の要素数は $1 \times 5 \times 5 =25$ なので、$(-1, 5)$ の-1 は 5 になる。つまり、logits.reshape(-1, vocab_size) は logits.reshape(5, 5) と同じ結果になる。
#学習
loss_history = []

for epoch in range(500):

    optimizer.zero_grad()

    # ----------------------------------------
    # Token Embedding
    # ----------------------------------------

    E = token_embedding(x)

    # ----------------------------------------
    # Position Embedding
    # ----------------------------------------

    P = position_embedding.unsqueeze(0)

    # ----------------------------------------
    # E + P
    # ----------------------------------------

    X = E + P

    # ----------------------------------------
    # 出力
    # ----------------------------------------

    logits = output(X)

    # ----------------------------------------
    # 損失
    # ----------------------------------------

    loss = F.cross_entropy(
        logits.reshape(-1, vocab_size),
        y.reshape(-1)
    )

    # ----------------------------------------
    # 逆伝播
    # ----------------------------------------

    loss.backward()

    # ----------------------------------------
    # パラメータ更新
    # ----------------------------------------

    optimizer.step()

    loss_history.append(loss.item())

    if epoch % 100 == 0:
        print(
            f"epoch={epoch:3d}, "
            f"loss={loss.item():.6f}"
        )
最後に、位置ベクトルが学習によってどう変化したかを確認し、学習結果を可視化する。
#学習後の位置エンコーディング

position_after = position_embedding.detach().clone()

print("\n【学習後の位置エンコーディング】")

for i in range(seq_len):
    print(
        f"位置 {i}: "
        f"{position_after[i].cpu().numpy()}"
    )


# ============================================================
#位置エンコーディングの変化
# ============================================================

difference = position_after - position_before

print("\n【位置エンコーディングの変化】")

for i in range(seq_len):
    print(
        f"位置 {i}: "
        f"{difference[i].cpu().numpy()}"
    )


# ============================================================
#最終予測
# ============================================================

with torch.no_grad():

    E = token_embedding(x)
    P = position_embedding.unsqueeze(0)

    X = E + P

    logits = output(X)

    prediction = logits.argmax(dim=-1)

print("\n【結果】")
print("入力 :", x.cpu().numpy())
print("正解 :", y.cpu().numpy())
print("予測 :", prediction.cpu().numpy())


# ============================================================
#損失のグラフ
# ============================================================

plt.figure(figsize=(7, 4))

plt.plot(loss_history)

plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("Training Loss")

plt.grid(True)
plt.show()


# ============================================================
#位置エンコーディングを2次元で表示
# ============================================================

P = position_after.cpu()

plt.figure(figsize=(6, 6))

plt.scatter(
    P[:, 0],
    P[:, 1]
)

for i in range(seq_len):

    plt.text(
        P[i, 0],
        P[i, 1],
        f" position {i}",
        fontsize=11
    )

plt.xlabel("Dimension 1")
plt.ylabel("Dimension 2")
plt.title("Learned Positional Embeddings")

plt.grid(True)
plt.show()
Mathematics is the language with which God has written the universe.